Daha fazla bilgi, her zaman daha iyi sonuç anlamına geliyor mu?
Merhabalar,
Bu yazıda agentic AI sistemlerinin en çok göz ardı edilen konularından biri olan context yönetimini konuşacağız. Bir agent’ın neyi, ne kadar süre hatırladığını, her şeyi hatırlamasının neden iyi bir fikir olmadığını ve bu işin pratikte nasıl çözüldüğünü inceleyeceğiz.
Başlamadan önce küçük bir senaryo düşünelim. Bir coding agent’a mevcut uygulamadaki müşteri arama ekranına yeni bir filtre eklemesini söylüyoruz.
Agent önce isteği analiz edip bir plan çıkarıyor. Repository’yi geziyor, ilgili component’i, servisleri ve modelleri buluyor. Birkaç dosya okuyor, benzer kullanımlara bakıyor ve değişiklikleri yapmaya başlıyor. Ardından projeyi build ediyor ve bir hata çıkıyor. Hata mesajını inceliyor, düzeltiyor, tekrar build alıyor. Bu sefer build başarılı ama bir test kırmızı. Bir düzenleme daha, bir çalıştırma daha ve görev tamamlanıyor.
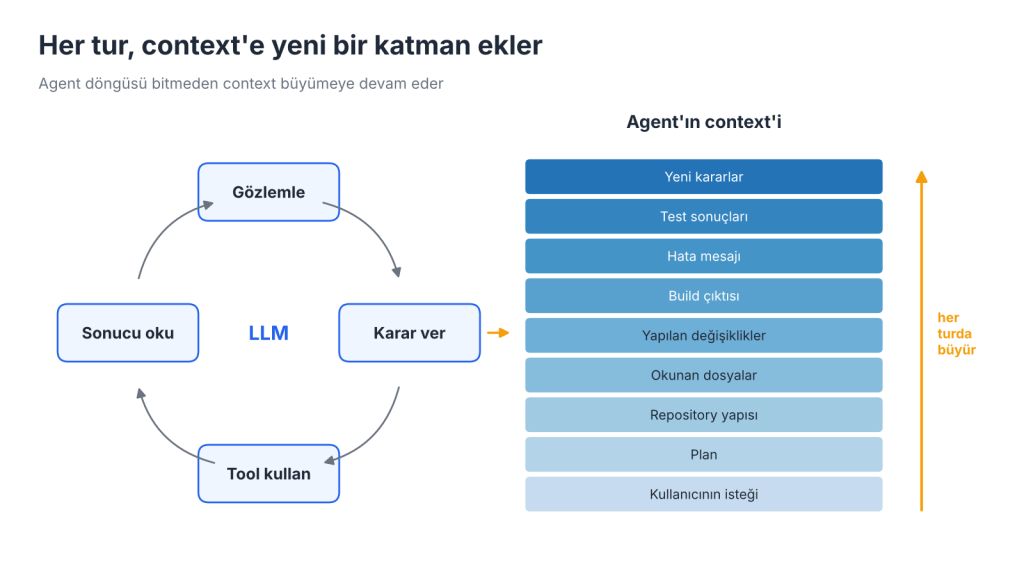
Coding agent kullanan herkes için bu akış artık çok tanıdık. Ama burada gözden kaçan bir şey var: Agent bu süreçte sadece kod yazmıyor, aynı zamanda sürekli bilgi topluyor.
İlk istek, plan, repository yapısı, okunan dosyalar, yapılan değişiklikler, terminal çıktıları, build hataları, test sonuçları, alınan kararlar… Hepsi giderek büyüyen bir çalışma geçmişine dönüşüyor. Görev birkaç adımlıksa sorun yok. Ama agent bir saat boyunca aynı iş üzerinde çalışıyorsa önünde ciddi bir bilgi yığını birikmiş oluyor.
Doğal olarak şu soru aklımıza geliyor: Agent bütün bunları hatırlamak zorunda mı?
İlk bakışta cevap “evet” gibi görünüyor. Daha fazla bilgi, daha doğru karar demek değil mi? Değil. Son zamanlarda sık duyduğumuz Context Engineering (bağlam mühendisliği) tam olarak bu soruyla ilgileniyor.
Önce Context Nedir?
Bir LLM’in cevap üretirken o anda görebildiği bilgilerin tamamına context diyoruz.
Modele sadece “Bu metottaki problemi düzelt.” dersek, hangi metottan bahsettiğimizi bilmiyor ve yapabileceği pek bir şey yok. Ama yanına ilgili kodu da koyarsak:
public Customer GetCustomer(int id){ return _customers .Where(x => x.Id == id) .First();}
model artık neyle uğraştığını biliyor. Bu kod, kullanıcının talebiyle birlikte modelin context’inin bir parçası oluyor.
Coding agent tarafında context çok daha geniş. Sistem talimatları, kullanıcının görevi, plan, konuşma geçmişi, okunan kaynak kodlar, tool tanımları, terminal çıktıları, build ve test sonuçları, hata mesajları ve önceki kararların hepsi aynı anda agent’ın önünde olabiliyor.
Context’i agent’ın çalışma masası gibi düşünebiliriz. Bir karar vereceği zaman masasındaki bilgilere bakıyor. Anthropic da context engineering’i, sürekli değişen olası bilgi havuzundan modelin sınırlı context window’una neyin gireceğini seçme işi olarak tanımlıyor.
Peki bu masaya ne kadar çok şey koyarsak o kadar mı iyi?
Masaya Ne Kadar Çok Dosya Koyarsak O Kadar mı İyi?
Bir geliştiricinin çözmesi gereken tek bir bug olduğunu düşünelim. Gerçekten ihtiyacı olanlar belki ilgili servis, bağlı olduğu repository, kullanılan DTO ve hata mesajı. Ama biz geliştiricinin önüne bütün solution’ı yazdırıp üstüne tüm logları, son altı aylık commit geçmişini, bütün test sonuçlarını ve eski araştırmaların tamamını koyuyoruz.
İhtiyacı olan bilgi bunların arasında olabilir. Ama artık yeni bir problemi var: Doğru bilgiyi gereksiz bilgilerin arasından ayıklamak. LLM’lerde de durum aynı. Anthropic bunu, istenen sonucu en olası kılan en küçük yüksek sinyalli token kümesini bulmak olarak özetliyor ve context’in sınırsız değil, getirisi giderek azalan bir kaynak olduğunu söylüyor.
Burada token kavramına gelmiş oluyoruz.
Token Neden Bu Kadar Konuşuluyor?
LLM’ler metni bizim gibi kelime kelime okumaz; metni token denen daha küçük parçalara böler. Kod, kullanıcı mesajları, hata çıktıları, tool sonuçları, agent’ın geçmişi… Hepsi modele token olarak girer.
Burada çoğu zaman gözden kaçan bir detay var: Model çağrıları arasında kendiliğinden bir hafıza yok. Agent her adımda, o ana kadar biriken context’i baştan sona yeniden modele gönderiyor. Basitleştirilmiş bir senaryoyla bakalım: Beş çağrıda context sırasıyla 8K, 18K, 27K, 38K ve 52K token oluyor.
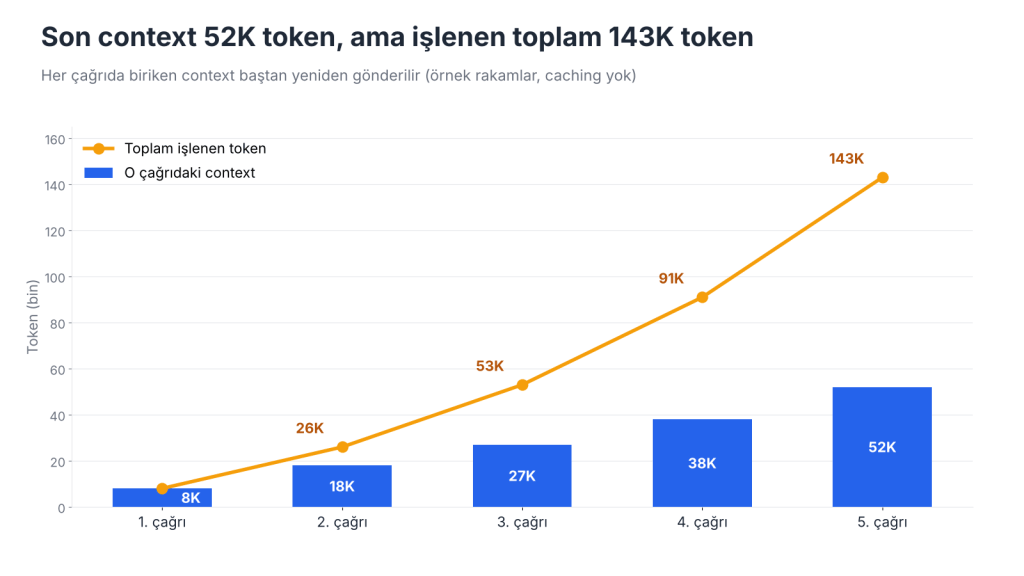
Son context 52.000 token gibi görünüyor. Ama model bu beş çağrıda toplam 143.000 token işledi, çünkü aynı bilgiler her turda yeniden okundu. Rakamlar mantığı göstermek için, ama problem gerçek: Uzun bir görevde işlenen toplam token, context’in büyümesinden çok daha hızlı artıyor.
Agent’larda bu dengesizlik daha da belirgin. Manus ekibi, agent’larında ortalama input/output token oranının yaklaşık 100’e 1 olduğunu paylaşıyor. Yani faturanın ve gecikmenin büyük kısmı modelin yazdığından değil, her turda yeniden okuduğundan geliyor.
İlk sonuç belli: Maliyet artıyor. İkincisi, agent yavaşlıyor. Ama asıl ilginç problem bu ikisi değil.
Daha Fazla Context, Daha İyi Cevap Demek Değil
Size iki sayfalık bir doküman verildiğini düşünün. İçindeki kritik bilgiyi bulmak kolay. Şimdi aynı iki sayfayı 300 sayfalık başka belgelerin arasına koyalım. Bilgi hâlâ orada ama onu bulmak ve doğru kullanmak çok daha zor.
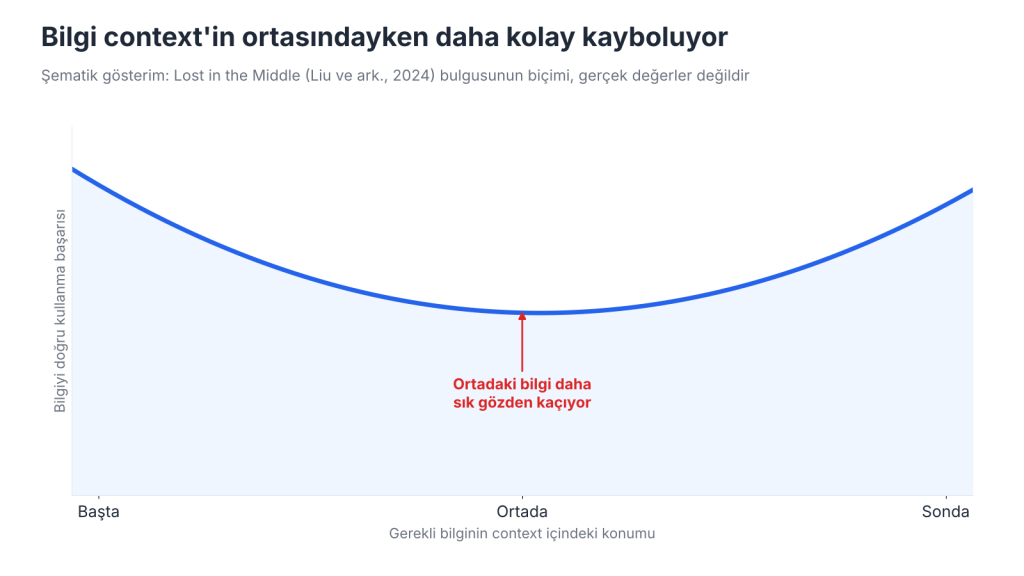
LLM’lerde uzun context kullanımını inceleyen en bilinen çalışmalardan biri Lost in the Middle. Araştırmacılar gerekli bilgiyi uzun bir context’in farklı noktalarına yerleştirip modellerin onu ne kadar iyi kullandığını test etmiş. Sonuç: Performans çoğu durumda bilgi başta veya sondayken yüksek, ortadayken düşük.
Bu sadece eski modellere özgü bir durum da değil. Chroma’nın 2025’te GPT-4.1, Claude 4, Gemini 2.5 ve Qwen3 dahil 18 modeli test ettiği Context Rot raporunda, görev zorluğu sabit tutulup yalnızca girdi uzatıldığında bile performans tüm modellerde düşmüş. Agent’lar açısından en önemli bulgu da şu: Konuyla ilgili ama yanlış bilgi içeren tek bir çeldirici bile başarıyı düşürüyor ve context uzadıkça bu etki büyüyor.
Coding agent için çeldirici çok tanıdık: Çoktan düzeltilmiş bir hatanın eski build çıktısı, artık geçerli olmayan bir dosya sürümü, vazgeçilmiş bir plan.
Yani “bu bilgiyi context window’uma sığdırabiliyorum” ile “bu bilgiyi gerektiğinde güvenilir şekilde kullanabiliyorum” aynı şey değil. Büyük bir depoya sahip olmak, içindeki her şeyi kolayca bulabileceğimiz anlamına gelmiyor.
Anthropic bu bozulmayı context rot kavramıyla anlatıyor. Transformer mimarisinde her token diğer tüm token’larla ilişki kurduğu için modelin bir dikkat bütçesi var ve her yeni token bu bütçeden biraz harcıyor.
İşte tam bu noktada Prompt Engineering’den farklı bir alana geçiyoruz.
Prompt Engineering Yetmiyor: Context Engineering
Prompt Engineering’de çoğunlukla şu soruyla ilgileniriz: Modele ne söylemeliyim? Talimat nasıl yazılır, rol nasıl tanımlanır, çıktı formatı nasıl belirtilir?
Context Engineering’de ise soru değişiyor: Model karar verirken önünde hangi bilgiler olmalı?
Küçük görünen bu fark agent sistemlerinde çok önemli, çünkü agent tek bir prompt’a cevap vermiyor; yazının başındaki döngüde çalışıyor: Gözlemliyor, karar veriyor, tool kullanıyor, sonucu okuyor ve yeniden karar veriyor. Anthropic’in agent tanımı da tam olarak bu: bir döngü içinde özerk şekilde tool kullanan LLM. Her döngü yeni context üretiyor. Prompt bir kez yazılıp bırakılıyor ama context’in her turda yeniden düzenlenmesi gerekiyor.
Peki bu nasıl yapılıyor? Altı başlıkta bakalım.
1. İhtiyaç Oldukça Getirmek (Just-in-Time)
Agent’a “CustomerService’teki filtreleme problemini çöz.” dediğimizi düşünelim. Kötü bir akışta agent bütün dosyaları okuyor, hepsini context’e koyuyor ve öyle çözmeye çalışıyor. İyi bir akışta ise görevi analiz ediyor, grep veya symbol aramasıyla ilgili yeri buluyor, CustomerService’i okuyor, bağımlılıklarına bakıyor ve gerekirse başka bir dosyayı açıyor.
Agent’ın repository’yi baştan bilmesi gerekmiyor. Anthropic buna just-in-time context diyor: Agent dosya yolu, sorgu, link gibi hafif referansları tutuyor, veriyi ancak ihtiyaç duyduğu anda tool’larla yüklüyor.
Pratikte en iyi sonuç genelde hibrit yaklaşımdan geliyor. Claude Code, CLAUDE.md dosyasındaki proje kurallarını en baştan context’e koyuyor, dosyaları ise glob ve grep ile o an buluyor. OpenAI Codex tarafında AGENTS.md aynı rolü üstleniyor. Zaten yeni bir projeye giren bir geliştirici de 5.000 dosyanın tamamını okumaz. Önce yapıya bakar, sonra ilgili projeye, class’a, gerekirse dependency’sine iner. Agent’tan beklenen de bu.
2. Tool’lar da Context Harcar
Genelde gözden kaçan iki kalem var: Tool tanımları ve tool cevapları.
Tanımlar her çağrıda context’in başında duruyor. Anthropic’in örneğinde beş MCP sunucusundan gelen 58 tool, konuşma daha başlamadan yaklaşık 55.000 token tüketiyor. Çözüm, tool’ları da ihtiyaç oldukça yüklemek: Tool search ile agent yalnızca lazım olan tanımları çağırıyor. Anthropic bu yöntemle token kullanımında yüzde 85 azalma raporluyor; OpenAI da defer_loading ile aynı yaklaşımı sunuyor.
Cevaplar tarafında mantık basit: Bir tool’un 20.000 satır döndürmesi agent için avantaj değil. Anthropic sayfalama, filtreleme ve makul varsayılan kısaltmalar öneriyor; Claude Code tool cevaplarını varsayılan olarak 25.000 token ile sınırlıyor. Örneğin read_logs yerine yalnızca ilgili satırları döndüren bir search_logs tool’u sorunu kaynağında çözüyor.
Bir adım ötesi programmatic tool calling. Agent tool’ları tek tek çağırmak yerine onları çağıran kısa bir kod yazıyor ve context’e yalnızca kodun nihai çıktısı giriyor. Anthropic karmaşık araştırma görevlerinde bununla yüzde 37 daha az token kullanıldığını aktarıyor.
3. Ham Tool Çıktısı Neden Sonsuza Kadar Taşınsın?
Agent build çalıştırdı ve 500 satırlık bir çıktı aldı. İçindeki önemli bilgi sadece şu:
CustomerSearchService.cs(84):Cannot implicitly convert type 'CustomerRequest' to 'CustomerFilter'
Agent sorunu anladı ve düzeltti. Peki bu 500 satırın 20 adım sonra hâlâ context’te durması gerekiyor mu? Çoğu zaman hayır. Ama kimse temizlemezse bu çıktılar birikiyor ve bir süre sonra context’in büyük kısmı, karar için artık gerekmeyen eski gözlemlerden oluşuyor. Üstelik az önce gördüğümüz çeldiricilere dönüşüyorlar.
Anthropic, işi biten tool sonuçlarını temizlemeyi context yönetiminin en güvenli ve en hafif biçimlerinden biri olarak görüyor ve Claude API’de bunu context editing özelliğiyle sunuyor: Eski tool sonuçları, kaldırıldıklarını belirten bir yer tutucuyla değiştiriliyor. Bu basitlik yanıltmasın. JetBrains Research’ün SWE-bench Verified üzerindeki çalışmasında, eski gözlemleri gizleyen bu basit yöntem (observation masking) maliyeti hiç yönetilmeyen agent’a göre yarıya indirmiş ve LLM ile özetleme yapan yöntemin başarı oranını yakalamış.
Temizlerken iki ayrıntı önemli. Birincisi Manus’un ilkesi: Dosyanın içeriği atılabilir ama yolu kalıyor, web sayfasının içeriği atılabilir ama URL’i kalıyor. Böylece agent gerekirse bilgiyi yeniden okuyabiliyor, yani sıkıştırma geri döndürülebilir oluyor. İkincisi hataların dersi: Manus, başarısız denemeleri context’te görmenin modelin aynı hatayı tekrarlamasını azalttığını gözlemliyor. 500 satır gidiyor ama “A yaklaşımı denendi, şu nedenle çalışmadı” satırı kalıyor.
4. Compaction: 30.000 Token’ı 2.000 Tokenlık Hafızaya Çevirmek
Agent uzun süre çalıştı: 24 dosya okudu, 7 dosyayı değiştirdi, üç çözüm denedi, ikisi çalışmadı, 10 kez build aldı. Bunların hepsini kelimesi kelimesine taşımak yerine geçmiş şuna dönüştürülebilir:
Görev: Customer search'e Brand filtresi eklemek.İncelenen ana alanlar: CustomerSearchService, CustomerRepository, CustomerFilter, CustomerSearchComponentAlınan karar: Filtre repository katmanında uygulanacak.Denenip vazgeçilen: UI taraflı filtreleme (pagination nedeniyle uygun değil).Mevcut durum: Build başarılı. CustomerSearchTests içinde iki test kırmızı.Sonraki adım: Test fixture'daki eski CustomerFilter oluşturma kodunu güncelle.
Agent artık 30.000 token taşımıyor ama önemli kararları da kaybetmiyor. Bu işleme compaction (sıkıştırma) deniyor.
Anthropic, Claude Code’da özetin mimari kararları, çözülmemiş hataları ve uygulama detaylarını koruduğunu, agent’ın da bu özet ve en son erişilen beş dosya ile devam ettiğini anlatıyor. Kendi compaction’ını yazanlara tavsiyesi de şöyle: Özet prompt’unu gerçek agent kayıtları üzerinde önce hiçbir şeyi kaçırmayacak, sonra gereksizi atacak şekilde ayarlamak.
Bunu elle yazmak da şart değil. OpenAI Responses API’de bir token eşiği (compact_threshold) aşıldığında sunucu tarafında otomatik compaction yapılabiliyor; Agents API ise compaction’ı kendisi yönetiyor. Claude API de sunucu tarafında compaction sunuyor.
Burada kritik nokta şu: Compaction geçmişi silmek değil, ham geçmişten gelecekte lazım olacak olanı ayırmaktır.
5. Her Bilgi Aynı Yerde Durmak Zorunda Değil
Agent’ın öğrendiği bilgilerin ömrü farklı. “84. satırda hata var” kısa ömürlü; hata çözülünce değerini kaybediyor. “Bu projede Controller repository katmanına doğrudan erişmez” ise görev boyunca, hatta sonraki görevlerde de geçerli bir kural. O yüzden context’i tek bir büyük metin olarak değil, katmanlar halinde düşünmek daha doğru:
- Proje kuralları (
AGENTS.md,CLAUDE.md): Kalıcı, her oturumda baştan yükleniyor. - Yapılandırılmış notlar (
NOTES.md, to-do listesi): Agent context dışında bir dosyaya not alıyor, gerektiğinde geri okuyor. Manus’un ilginç bir gözlemi var: Agent to-do listesini her adımda yeniden yazdığında ana hedef context’in sonuna taşınıyor. Lost in the Middle’da gördüğümüz “ortada kaybolma” sorununa karşı basit bir önlem. - Memory: Oturumlar arasında taşınan kararlar ve tercihler. Anthropic’in dosya tabanlı memory tool’u bunun için tasarlanmış.
- Alt agent’lar: Repository taraması gibi keşif işleri temiz bir context’le çalışan alt agent’a veriliyor. Anthropic’e göre alt agent on binlerce token harcayabiliyor ama ana agent’a genellikle 1.000–2.000 tokenlık bir özet dönüyor. Ayrıntı alt agent’ta kalıyor, ana agent’ın masası temiz kalıyor.
6. Prompt Caching ile Compaction Aynı Şey Değil
İkisi sık karıştırılıyor. İkisi de maliyetle ilgili ama farklı problemleri çözüyor.
Compaction context’i gerçekten küçültüyor: 40.000 tokenlık geçmiş 5.000 tokenlık özete iniyor. Prompt caching ise aynı prompt başlangıcının (prefix) tekrar tekrar hesaplanmasını önlüyor. Coding agent’ın her çağrısında sistem talimatları, tool tanımları ve proje kuralları aynıysa bu ortak kısım yeniden kullanılabiliyor. OpenAI’da caching desteklenen modellerde varsayılan olarak açık ve cache’ten okunan input token’lar yüzde 95’e varan indirimle fiyatlanıyor. Manus’un Claude Sonnet üzerinden verdiği örnekte cache’li token, cache’siz olana göre 10 kat ucuz.
Ama caching context’in kalabalığını çözmüyor; model o bilgileri yine görüyor. Kısaca:
Caching aynı bilgiyi daha ucuza işler. Compaction ise taşınan bilgi miktarını azaltır.
Caching’in bir şartı var: Prefix’in birebir aynı kalması. Tek bir token farklılaştığında o noktadan sonrasının cache’i geçersiz oluyor. Bu yüzden context’in sırası da tasarımın parçası. Sabit içerik (sistem talimatları, tool tanımları, proje kuralları) başta, değişen içerik sonda duruyor. Geçmiş mümkün olduğunca yalnızca ekleniyor, eski adımlar yeniden yazılmıyor. Sistem prompt’unun başına saniyesine kadar zaman damgası koymak, Manus’un örnek verdiği klasik bir cache katili. Görev ortasında tool tanımı eklemek veya çıkarmak da aynı etkiyi yapıyor; bu yüzden bir tool’u kapatmak gerektiğinde OpenAI tanımı silmek yerine allowed_tools ile kısıtlamayı öneriyor, Manus da tool’ları kaldırmak yerine maskeliyor.
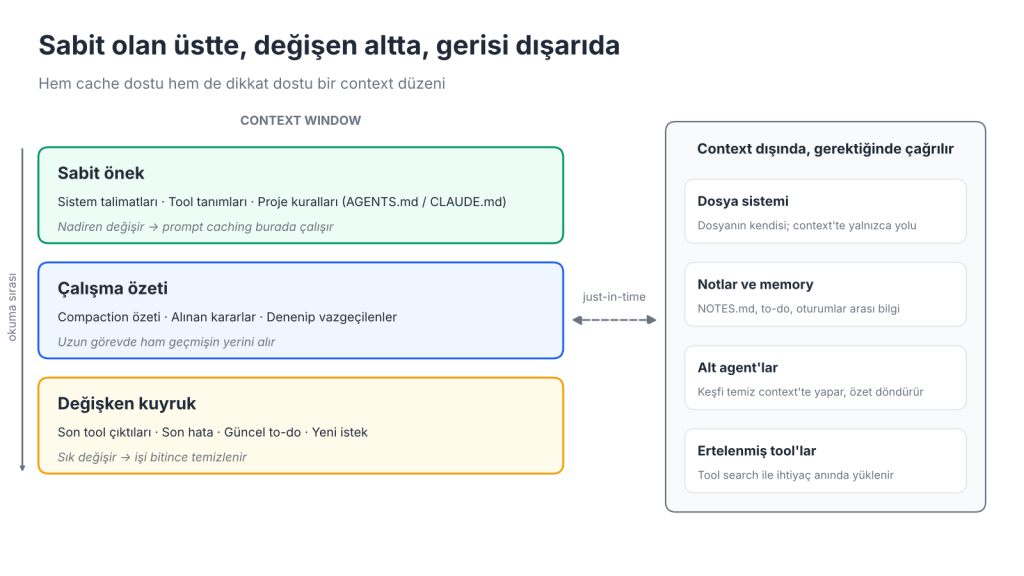
Burada ince bir gerilim var: Compaction ve eski çıktıları temizlemek geçmişi değiştirdiği için cache’in o noktadan sonrası boşa gidiyor. OpenAI bunu açıkça belirtiyor ve tek bir metriğe değil toplam maliyete bakılmasını öneriyor; daha az token, düşen cache oranına rağmen yine de daha ucuz olabiliyor. Pratik sonuç: Temizliği her turda azar azar değil, bir eşik aşıldığında toplu yapmak daha mantıklı.
Peki İyi Bir Coding Agent Bunları Bir Araya Nasıl Getiriyor?
Baştaki örneğe dönelim: “Müşteri arama ekranına Brand filtresi ekle.”
Kötü tasarlanmış bir agent bütün repository’yi tarıyor, bulduğu her dosyayı context’e koyuyor, her build ve test çıktısını sonuna kadar taşıyor. Görev uzadıkça hem pahalılaşıyor hem de kendi eski çıktıları arasında kayboluyor.
İyi tasarlanmış bir agent ise ilgili component’i arayarak buluyor, servisleri ihtiyaç oldukça okuyor, build hatasından yalnızca ilgili satırı ve çıkardığı dersi saklıyor, çözülen hatanın ham çıktısını bırakıyor, kararlarını kısa notlara çeviriyor ve context bir eşiği aşınca compact ediyor.
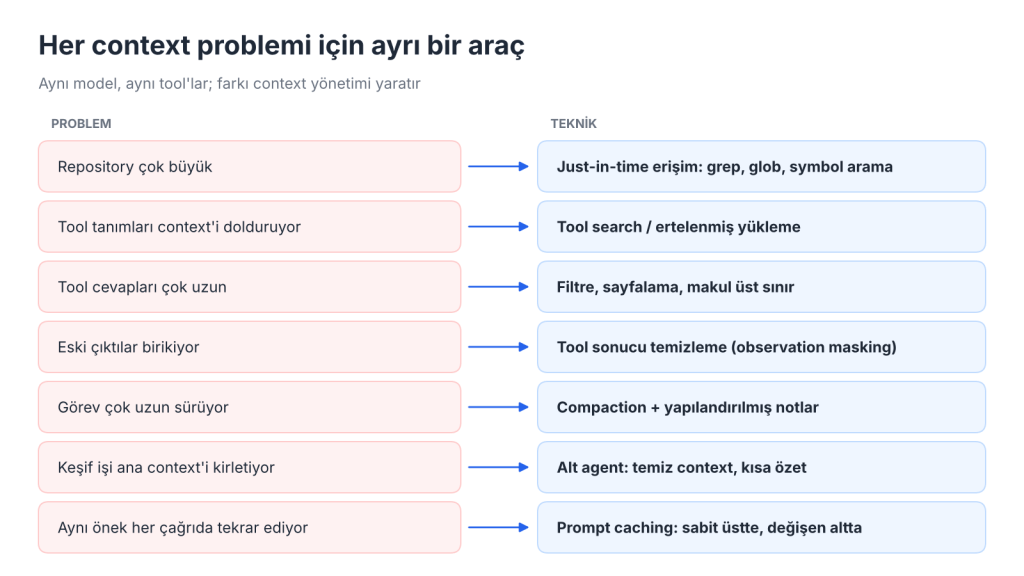
İki agent da aynı LLM’i, aynı repository’yi ve aynı tool’ları kullanıyor olabilir. Aralarındaki farkı yaratan model değil, context’in yönetimi.
Daha Büyük Context Window Bu Problemi Çözmez mi?
Kısmen çözer, tamamen çözmez.
Context window büyüyünce agent’ın çalışma alanı genişliyor, bu faydalı. Ama “o alanda hangi bilgi olmalı?” sorusu ortadan kalkmıyor. Masayı iki kat büyütürsek üzerine iki kat fazla dosya koyabiliriz, ama doğru dosyayı bulma problemimiz yerinde duruyor. Context Rot bulguları da bunu gösteriyor: Performans, pencere dolmadan çok önce düşmeye başlıyor. Anthropic de öngörülebilir gelecekte her boyuttaki context window’un bu kirlilik ve alakasız bilgi sorunlarına açık olacağını düşünüyor.
Yani iyi bir agent mimarisinin amacı context window’u doldurmak değil, kullanmak.
Toparlarsak
Bu yazıda gördüğümüz tekniklerin hepsi aslında aynı soruya farklı yerlerden cevap veriyor: Agent’ın şu anda bu bilgiyi görmesine gerçekten gerek var mı?
Repository’yi baştan okutmak yerine arama ve symbol lookup veriyoruz, kalıcı kuralları kısa bir AGENTS.md / CLAUDE.md dosyasında topluyoruz. Tool tanımlarını ve cevaplarını da context bütçesinin bir parçası sayıyoruz. İşi biten çıktıyı temizlerken dersini ve referansını bırakıyoruz. Geçici bilgiyle kalıcı bilgiyi ayırıyoruz; uzun görevlerde compaction, keşif işlerinde alt agent devreye giriyor. Sabit içerik başta, değişen içerik sonda duruyor ki cache çalışsın.
Bir de ölçme tarafı var. Görev başına toplam token, cache isabet oranı ve görev başarı oranına birlikte bakmak gerekiyor. Context’i küçültelim derken agent’ın ihtiyacı olan bilgiyi de atarsak, daha ucuz ama daha kötü bir sistem elde ediyoruz.
Baştaki soruya dönersek: Agent her şeyi hatırlamalı mı? Hayır.
İyi bir agent her şeyi hatırlayan agent değildir. Neyi hatırlaması gerektiğini, neyi tekrar bulabileceğini ve neyi artık unutabileceğini bilen agent’tır.
Agent’lar daha uzun süre çalıştıkça, daha büyük kod tabanlarında görev aldıkça ve daha fazla tool kullandıkça bu ayrımın önemi artacak. Belki de önümüzdeki dönemde güçlü agent sistemlerini birbirinden ayıran şey, yalnızca hangi modeli kullandıkları değil, o modelin context’ini ne kadar iyi yönettikleri olacak.
Bir sonraki yazıda görüşmek üzere.
İyi çalışmalar.

