Giriş
Bir AI agent’a küçük bir geliştirme işi verdiğimizi düşünelim:
“Sipariş iptal edilirken kargoya verilmiş siparişlerin iptal edilmesini engelle.”
İş birkaç satırlık bir kontrol gibi görünüyor. Fakat agent çalışmaya başladığında repository içerisinde arama yapıyor, birkaç klasörü inceliyor, ilgili olabilecek dosyaları açıyor, interface’lere ve testlere bakıyor, build çalıştırıyor, hata çıkınca terminal çıktısını okuyor ve bazen daha önce baktığı dosyalara yeniden dönüyor.
Sonunda ekrana baktığımızda belki dört satırlık bir değişiklik görüyoruz. Ama o dört satıra ulaşabilmek için modelin işlediği bilgi bunun katbekat üzerinde olabiliyor.
AI agent’larda token maliyetinin önemli bir bölümü üretilen koddan değil, o kodu üretebilmek için okunan, taşınan ve tekrar işlenen context’ten geliyor.
Bu yüzden token optimizasyonunu yalnız “prompt’u biraz daha kısa yazmak” olarak düşünmek eksik kalıyor. Asıl soru şu: Agent’ın bir sonraki doğru kararı verebilmesi için gerçekten hangi bilgiye ihtiyacı var?
Bir agent çalışırken modele yalnızca son mesajımız gitmeyebilir. Kullanılan sisteme göre sistem talimatları, proje kuralları, konuşma geçmişi, açılan kaynak kodlar, arama sonuçları, tool tanımları, terminal çıktıları ve hata mesajları da çalışma context’inin parçası olabilir. Anthropic’in context engineering yaklaşımı da tam olarak burada yüksek sinyalli, görev için gerekli bilginin seçilmesini öne çıkarıyor.
Bunu bir çalışma masasına benzetebiliriz. Masaya ihtiyacımız olan beş belgeyi koyarsak neye bakacağımız bellidir. Ama aynı masaya bütün proje dokümanlarını, eski logları, kullanılmayacak araçların kılavuzlarını ve artık geçerli olmayan kararları da bırakırsak bilgi miktarı artar; karar vermek mutlaka kolaylaşmaz.
1. Kötü Yöntem: “Önce Tüm Projeyi İncele”
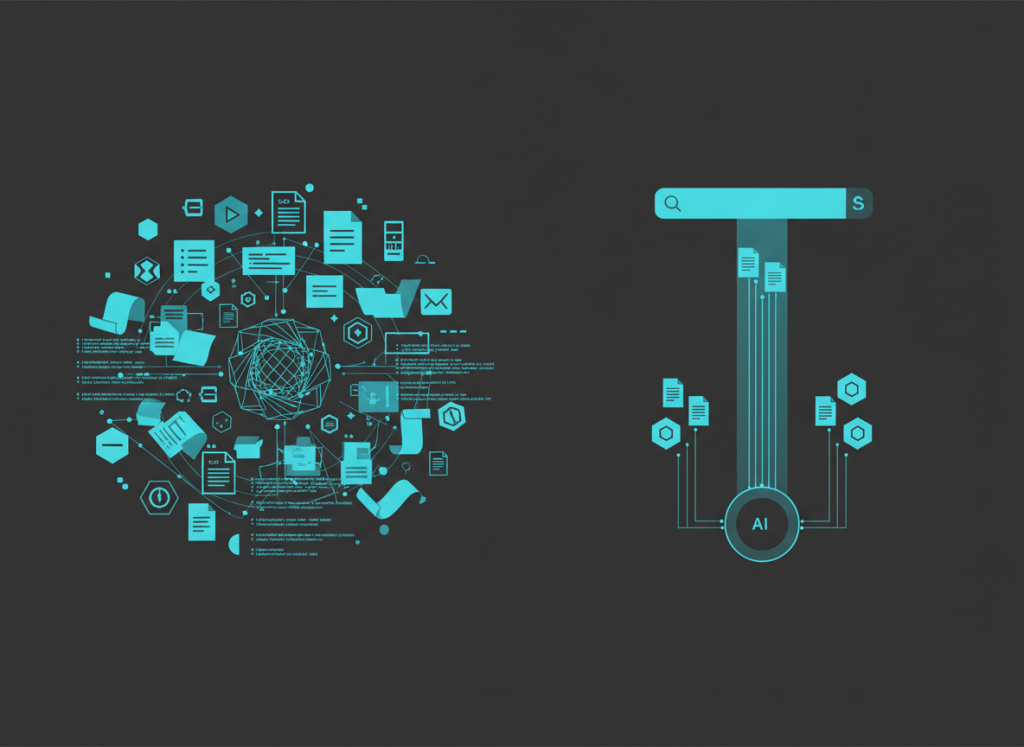
Bir task verirken “Önce projeyi detaylıca analiz et, mimariyi tamamen anla, sonra geliştirmeye başla.” demek güvenli görünebilir. Fakat büyük bir repository’de bu talimat küçük bir bug fix’i kolayca repository keşif projesine dönüştürebilir.
Kargoya verilmiş siparişin iptalini engellemek için agent’ın bütün sistemi baştan sona anlaması gerekmeyebilir. Önce CancelOrder, OrderStatus, Shipment veya ilgili hata mesajı gibi güçlü ipuçlarını araması çok daha verimlidir. Arama sonucunda birkaç güçlü aday bulunduysa önce yalnızca bu dosyaların ilgili bölümleri okunur. Yeni bir dependency ortaya çıkarsa kapsam o noktada genişletilir.
Task
  ↓
Search
  ↓
Shortlist
  ↓
Targeted Read
  ↓
Gerekirse dependency'ye genişle
  ↓
Implement
Burada “en fazla beş dosya oku” gibi katı bir sınır da doğru değil. Bazı işler gerçekten daha geniş analiz gerektirir. Asıl kural dosya sayısını sınırlamak değil, küçük başlayıp ihtiyaç kanıtlandıkça context’i genişletmektir.
Bunu kendi projemde nasıl uygularım?
Repository seviyesindeki agent instruction dosyanıza şu davranışı ekleyebilirsiniz:
For repository tasks, do not scan the entire repository by default.

Start with:
Search → shortlist relevant files and symbols → targeted reads.

Expand to callers, dependencies, interfaces and tests only when
the current evidence shows they are needed.

Prefer symbol search, references and targeted reads over broad
directory scans.

Do not reread unchanged files unless their current content is
required for the next decision.
GitHub Copilot kullanıyorsanız repository genelindeki talimatları .github/copilot-instructions.md altında tutabilir, daha özel kuralları ise desteklenen yapılarda path-specific instruction’lara ayırabilirsiniz.
2. Kötü Yöntem: “Belki Lazım Olur, Bütün Tool’lar Açık Kalsın”
Modern agent’lar yalnızca kod üretmiyor. Terminal, Git, browser, issue tracker, log sistemi, veritabanı ve MCP servisleri gibi birçok araca bağlanabiliyor. Burada doğal refleks “Hepsini bağlayalım, gerektiğinde agent seçer.” oluyor.
Fakat bir tool’un seçilebilmesi için modelin o tool’un ne olduğunu bilmesi gerekir. Birçok agent mimarisinde tool adı, açıklaması ve parametre şeması modele sunulan context’in parçasıdır. Yani agent o aracı hiç kullanmasa bile tanımı token tüketebilir.
Anthropic’in yayımladığı bir örnekte GitHub, Slack, Sentry, Grafana ve Splunk’tan oluşan 58 tool’un tanımları yaklaşık 55 bin tokenlık yük oluşturabiliyor. GitHub da Tool Search dokümantasyonunda birkaç düzine tool tanımının agent çalışmaya başlamadan önce 10–20 bin token tüketebileceğini belirtiyor.
Buradan çıkacak sonuç “MCP kullanmayın” değil. Daha doğru sonuç şu: Agent’ın çok sayıda araca erişebilmesi ile bütün araçların tanımlarını her görevde baştan taşıması aynı şey olmak zorunda değil.
Aynı problem tool çıktılarında da yaşanır. “Bugünkü production loglarını getir.” demek yerine “14:00–15:00 arasında OrderService için bu CorrelationId ile ilişkili ERROR kayıtlarını ve hatanın çevresindeki gerekli satırları getir.” demek çok daha az ama çok daha yüksek sinyalli bilgi üretir. Anthropic de tool tasarımında filtering, pagination ve kontrollü çıktı boyutunu özellikle öneriyor.
Uygulanabilir kural
Use the smallest sufficient tool set for the current task.

Do not invoke external tools when repository context is sufficient.

For tools that may return large results, filter by time range,
identifier, file path, error level or another relevant criterion.

Prefer targeted search tools over broad list/read operations.
Her tool çağrısından önce iki soru yeterli olabilir: Bu araca gerçekten ihtiyacım var mı? ve Bu araç gerçekten bu kadar veri döndürmek zorunda mı?
3. Kötü Yöntem: Aynı Conversation’ı Sonsuza Kadar Taşımak
Uzun bir coding session düşünelim. Sabah araştırma yapıldı, plan çıkarıldı, bir yaklaşım denendi, build bozuldu, hatalar çözüldü ve öğleden sonra aynı conversation içinde review’a geçildi.
Bu noktada history’nin tamamı eşit derecede değerli değildir. Güncel kararların yanında artık yanlış olan hipotezler, çözülmüş hatalar, eski terminal çıktıları ve repository’den gerektiğinde yeniden bulunabilecek bilgiler de taşınmaya devam edebilir.
Daha iyi yaklaşım, conversation’ın tamamını kalıcı hafıza gibi kullanmak yerine durumu yani state’i taşımaktır. OpenAI’ın session memory örnekleri de uzun history için trimming ve compression gibi yaklaşımları gösteriyor; Anthropic ise uzun süre çalışan coding agent’larda yapılandırılmış progress bilgisini benzer amaçla kullanıyor.
# Goal
Shipped siparişlerin iptal edilmesini engelle.

# Relevant Files
CancelOrderHandler.cs
Order.cs
CancelOrderTests.cs

# Decisions
Mevcut validation mekanizması kullanılacak.
ShipmentStatus = Shipped ise işlem reddedilecek.

# Completed
Business rule eklendi.
Unit testler geçti.

# Remaining
Integration test.
Final diff review.

# Risks
Partial shipment senaryosu kontrol edilmeli.
Buraya kodu veya büyük terminal çıktılarını kopyalamaya gerek yok. Kod zaten repository’de. Handoff dosyasında yalnızca yeniden keşfedilmesi pahalı olan bilgi tutulmalı: amaç, önemli dosyalar, kararlar, tamamlanan işler, kalan işler, validation durumu ve bilinen riskler.
Yeni session da “Eski conversation’ı yeniden oluştur.” diye başlamamalı. Daha sağlıklı talimat şöyledir:
Read AGENT_HANDOFF.md first.
Then verify the current state from the repository.
Do not reconstruct the old conversation.
Continue from Remaining.
Her küçük bug fix için yeni session açmak gereksizdir. Kriter süre değil; geçmiş context’in ne kadarının bir sonraki karar için hâlâ gerekli olduğudur.
4. Kötü Yöntem: Her Proje Kuralını Her Task’a Yüklemek
Projede mimari kurallar, naming standartları, frontend prensipleri, database migration yaklaşımı, test kuralları ve deployment notları olabilir. Bunların hepsini tek ve sürekli büyüyen instruction dosyasına koymak başlangıçta pratik görünür.
Fakat küçük bir backend değişikliği yapan agent’ın frontend component kurallarını veya migration prosedürlerini her seferinde taşıması gerekmez.
Daha temiz yaklaşım, talimatları iki katmana ayırmaktır. Her task’ta geçerli küçük bir çekirdek bulunur; alan bazlı kurallar yalnız gerektiğinde yüklenir.
Preserve existing architecture.
Search before broad repository reading.
Prefer existing patterns.
Make the minimum necessary change.
Run the smallest relevant validation first.
Backend, frontend, database ve testing kuralları ayrı dosyalarda tutulabilir. Aynı yaklaşım repository haritasında da kullanılabilir. İyi bir REPO_MAP.md her class’ı anlatmaz; agent’a hangi bölgeye bakması gerektiğini gösterir.
Kısacası amaç agent’a her şeyi öğretmek değil, doğru anda doğru kuralları göstermektir.
5. Kötü Yöntem: Review’da Repository’yi Baştan Keşfetmek
Implementation bittiğinde “Projeyi detaylıca incele ve yaptığın değişikliği review et.” demek geliştirme sırasında yaptığımız keşfi ikinci kez başlatabilir.
Oysa review aşamasında elimizde çok güçlü bir başlangıç noktası vardır: git diff.
Task + Acceptance Criteria
          ↓
        Git Diff
          ↓
     Changed Files
          ↓
    Relevant Tests
          ↓
Gerekirse caller / dependency
Agent önce değişen satırlara bakar. Bir değişikliğin etkisini doğrulamak için caller, interface veya domain rule gerekiyorsa yalnız o noktada kapsam genişletilir.
Aynı yaklaşım debugging için de geçerlidir. “Projeyi analiz et.” yerine “İlk failing test veya compile error’dan başla, en küçük ilgili execution path’i incele ve mevcut kanıt gerektirirse kapsamı genişlet.” demek hem daha kontrollü hem de daha verimlidir.
Buradaki kazanç yalnız token tasarrufu değildir. Agent’ın araştırmayı kanıttan başlayarak yapmasını sağlarız.
Peki Prompt Caching Bu Problemi Çözmüyor mu?
Prompt caching oldukça yararlı, fakat farklı bir problemi çözüyor. OpenAI’ın prompt caching dokümantasyonunda da anlatıldığı gibi tekrar eden prompt prefix’leri ve diğer sabit context parçaları cache üzerinden yeniden kullanılabildiğinde maliyet ve gecikme azalabiliyor.
Ama cache edilen gereksiz bilgi, gerekli bilgiye dönüşmez.
50 bin tokenlık gereksiz tool tanımını daha ucuza işlemek hâlâ 50 bin tokenlık gereksiz tool tanımı taşımaktır.
Önce gereksiz context'i çıkar
        ↓
Kalan gerekli context'i düzenle
        ↓
Tekrar eden kısmı mümkünse cache et
Aynı ayrım daha ucuz model kullanmak için de geçerli. Model maliyet optimizasyonu ile context optimizasyonu aynı problem değildir.
İyi Bir Coding Agent Workflow’u Nasıl Görünmeli?
Bütün yaklaşımı tek bir geliştirme akışına indirgersek:
TASK
 ↓
SEARCH
 ↓
SMALL RELEVANT CONTEXT
 ↓
TARGETED READ
 ↓
ONLY REQUIRED TOOLS
 ↓
IMPLEMENT
 ↓
TARGETED VALIDATION
 ↓
DIFF-FIRST REVIEW
 ↓
HANDOFF IF NEEDED
Kötü workflow güveni “daha fazla bilgi toplayarak” sağlamaya çalışır. İyi workflow ise her adımda şu soruyu sorar:
Bir sonraki doğru kararı verebilmek için şimdi hangi bilgi eksik?
Bu küçük zihinsel değişiklik repository okumalarından tool kullanımına, session yönetiminden review’a kadar bütün agent davranışını etkiler.
Tek Bir Agent Policy ile Başlamak İsterseniz
Yukarıdaki yaklaşımın kısa bir sürümünü doğrudan repository seviyesinde kullanabilirsiniz:
TOKEN-EFFICIENT AGENT POLICY

Keep context focused on the current task.

Start with search and targeted reads.
Do not scan the entire repository by default.
Expand to callers, dependencies, interfaces and tests only when needed.

Use the smallest sufficient tool set.
Filter large tool results before loading them into context.

Load only project rules relevant to the current area.

For long-running work, persist goals, decisions, relevant files,
completed work, remaining work and validation state.
Do not use the full conversation as permanent memory.

Validate the smallest affected scope first.

For review and debugging, start from the diff, failing test or error.
Expand only to investigate a concrete concern.

Prefer tokens spent on evidence, current code, decisions and
validation over narration.
Bu policy’nin değeri birkaç yüz tokenlık prompt tasarrufundan gelmiyor. Agent’a context bütçesini nasıl harcaması gerektiğini öğretiyor.
Sonuç
AI agent’larda token optimizasyonu denildiğinde ilk akla gelen yöntem genellikle prompt’u kısaltmak oluyor. Elbette gereksiz uzun promptlar yazmamak faydalı. Ancak coding agent’larda asıl maliyet çoğu zaman başka yerde büyüyor: gereksiz repository okumalarında, ihtiyaç duyulmayan tool tanımlarında, filtrelenmemiş çıktılarda, saatlerce taşınan conversation geçmişinde ve zaten bildiğimiz kodu ikinci kez keşfederken.
Bu nedenle token tasarrufunu “modele daha az bilgi vermek” olarak değil, gereksiz bilgiyi sürekli taşımamak olarak düşünmek daha doğru.
Repository’yi komple taratmak yerine önce aramak, bütün tool’ları her görevde yüklemek yerine ihtiyaç anında kullanmak, uzun conversation’ı hafıza gibi taşımak yerine önemli state’i saklamak, proje kurallarını katmanlara ayırmak ve review’a diff üzerinden başlamak günlük kullanımda doğrudan uygulanabilecek yöntemler.
Daha büyük context window’lar gelecek, caching yöntemleri gelişecek ve agent’lar daha uzun süre çalışabilecek. Fakat context kapasitesinin büyümesi gereksiz bilginin değerli hale geldiği anlamına gelmiyor.
Uzun vadede iyi bir agent sistemi yalnızca çok fazla bilgiye erişebilen sistem olmayacak. Hangi bilgiye şimdi ihtiyacı olduğunu, hangisini gerektiğinde yeniden bulabileceğini ve hangisini artık bırakabileceğini bilen sistem olacak.
İyi çalışmalar.

