Merhabalar,
Bu yazıda yapay zekâ dünyasında son zamanlarda fazlaca konuşulan bir model olan Jev’i inceleyeceğiz. Jev’in ne olduğunu, bir LLM’den nasıl farklı çalıştığını, neden bu kadar hızlı ve ucuz olabildiğini, AI agent’larda skill ve araç seçiminde nasıl kullanıldığını ve sınırlarını örneklerle ele alacağız.
Dakikada Yüz Küçük Karar
Bir e-ticaret sitesinin destek kutusuna her dakika yüzlerce mesaj düşüyor. Biri kargosunu soruyor, biri iade istiyor, biri öfkeyle aboneliğini iptal etmekle tehdit ediyor. Yazılımın her mesaj için bilmesi gereken tek şey şu: Bu mesaj hangi masaya gidecek?
Bugün bu işi çoğu zaman ChatGPT ya da Claude gibi büyük dil modelleri (LLM) yapıyor. Doğru da yapıyorlar. Ama her mesajda bir iki saniye bekletiyor ve her mesaj için ayrı ayrı fatura kesiyorlar; tek kelimelik bir cevap için koca bir yazarı mesaiye çağırmak gibi.
15 Eylül 2026’da TypeSafe AI adlı bir girişim bu soruna farklı bir cevap verdi: Jev. Jev nedir? Metin yazmayan, kod yazmayan, açıklama yapmayan; yazılım için doğrudan bir seçim, bir puan ya da bir olasılık döndüren yapay zekâ modelidir. TypeSafe bu yeni türe “System One modeli” diyor.
Peki hiç konuşmayan bir yapay zekâ nasıl olur da işe yarar? Bir LLM’den neden bu kadar hızlı ve ucuz olabiliyor? Ve nerede işe yaramıyor? Önce bir LLM’in cevabı nasıl yazdığına bakalım; Jev’in farkı oradan çok daha net görünüyor.
Önce Temel: Bir LLM Cevabını Nasıl Yazar?
Bir LLM’in işi iki aşamadan oluşur: önce okur, sonra yazar. Jev’i anlamanın anahtarı, bu iki aşamanın maliyetinin birbirinden çok farklı olmasıdır.
Okuma aşaması. Siz bir soru gönderdiğinizde model metnin tamamını tek seferde işler. Mühendisler buna prefill der. Bu aşama hızlıdır, çünkü bütün kelimeler aynı anda, paralel olarak hesaplanır.
Yazma aşaması. Asıl yavaşlık burada başlar. LLM cevabını tek parça halinde veremez; token denen küçük parçalar halinde, birer birer yazar. Token kabaca bir kelime ya da kelime parçasıdır; “Olumlu” kelimesi model için bir veya birkaç token olabilir.
Her yeni token için model, milyarlarca parametrelik ağın tamamından bir kez daha geçer ve “bir sonraki parça ne olmalı?” diye sorar. Bir sonraki parça, öncekiler bitmeden başlayamaz. Bu sıralı üretime autoregressive generation, yani ardışık üretim denir.
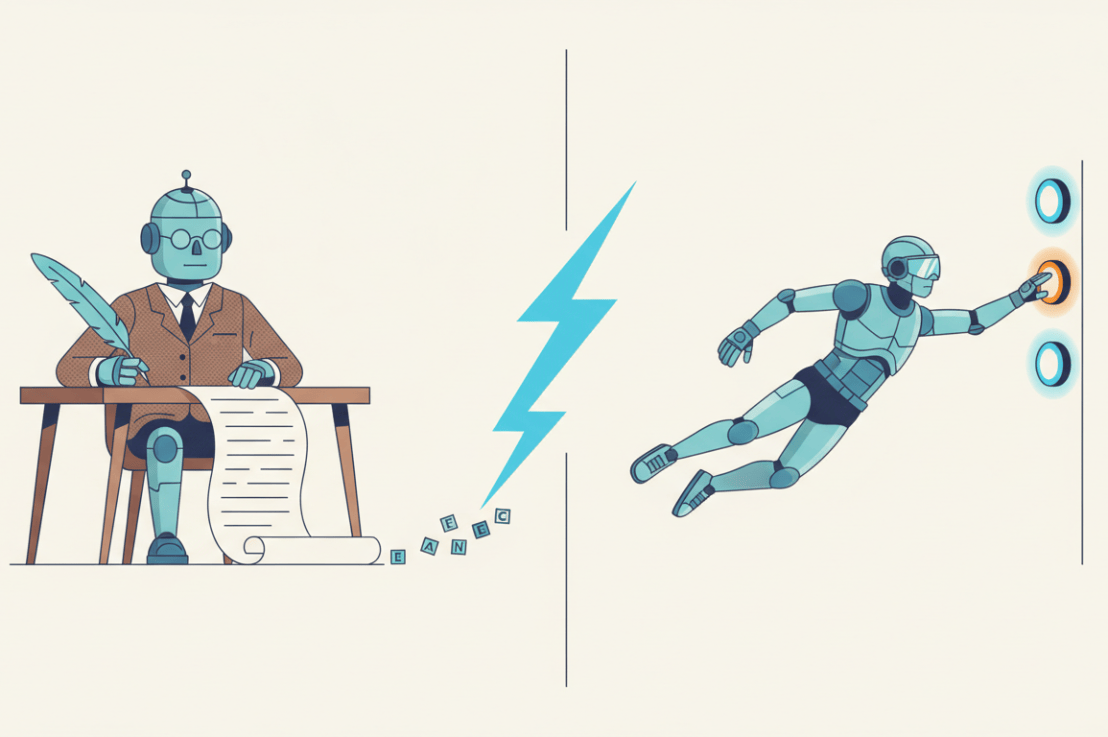
Bunu, cevabı bildiği halde onu kâğıda tek tek yazmak zorunda olan bir öğrenci gibi düşünebilirsiniz. Cevap ne kadar kısa olursa olsun, kalem kâğıda değmek zorundadır.
Yapay zekâ dünyasında bunu özetleyen basit bir kural vardır: Okumak ucuz ve hızlıdır, yazmak pahalı ve yavaştır. Fiyat listeleri de bunu söyler. OpenAI’ın GPT-5.6 Terra modeli milyon girdi tokenı için 2 dolar, milyon çıktı tokenı için 12 dolar istiyor (The Register); yazmak, okumanın altı katı pahalı.
Jev Nedir? Konuşmayan, Sadece Karar Veren Bir Model
Jev, San Francisco merkezli TypeSafe AI’ın 15 Eylül 2026’da erken erişime açtığı bir karar modeli. Ona bir metin ya da JSON verisi verirsiniz (TypeSafe buna state, yani “durum” diyor) ve önceden tanımladığınız soruları sorarsınız. O da yalnızca bu sorulara cevap döndürür: bir seçim, bir puan ya da bir olasılık. Yazı yok, gerekçe yok, kod yok (Sanity).
Şirketin kurucusu Diogo Almeida, OpenAI’da çalışmış ve ChatGPT’nin temelini oluşturan InstructGPT çalışmasının yazarlarından biri. Yani “sohbet etmeyen yapay zekâ” fikri, sohbet botlarını yapanların içinden çıktı. TypeSafe, gizlilikten çıktığı gün DCVC liderliğinde 40 milyon dolarlık tohum yatırımı açıkladı (SiliconANGLE).
Neden “System One”?
TypeSafe, Jev’i “ilk System One modeli” olarak tanıtıyor. İsim, Nobel ödüllü psikolog Daniel Kahneman’ın Hızlı ve Yavaş Düşünme kitabından geliyor. Kahneman’a göre zihnimiz iki sistemle çalışır:
- Sistem 1 hızlı ve sezgiseldir. Yüzünüze gelen topa elinizi kaldırmanız ya da bir yüzdeki öfkeyi anında fark etmeniz gibi.
- Sistem 2 yavaş ve dikkatlidir. Bir vergi beyannamesini doldurmanız ya da 17 × 24’ü hesaplamanız gibi.
Adım adım akıl yürüten, uzun cevaplar yazan LLM’ler Sistem 2 rolündedir. Jev ise öbür tarafı hedefliyor: bir yazılımın saatte binlerce kez vermesi gereken hızlı, refleks kararları.
Bağımsız geliştirici Flavio Copes, Jev’i en sade haliyle “akıllı bir if ifadesi” diye tarif ediyor (The New Stack). Programlamada if, “şu doğruysa bunu yap” demektir. Jev, o “doğru mu?” sorusunu metni anlayarak sizin yerinize cevaplayan bir if.
Jev Nasıl Cevap Verir? Üç Soru Tipi
Jev’le sohbet edilmez; ona soru tipleri tanımlanır. Yalnızca üç tip var ve her çağrı bunlardan kurulur (Sanity).
| Soru tipi | Ne sorar? | Ne döndürür? | Örnek |
|---|---|---|---|
| Choice (Seçim) | Bu seçeneklerden hangisi? En fazla 255 seçenek | Kazanan seçenek, her seçeneğin olasılığı ve bir güven değeri | Mesaj fatura mı, teknik mi, satış mı? |
| Score (Puan) | Tanımladığınız ölçeğin neresinde? 2 ile 10 basamak arası | Basamaklar arasına da düşebilen bir puan, her basamağın olasılığı, güven değeri | Müşteri 1 ile 5 arasında ne kadar öfkeli? |
| Noul (Evet/hayır olasılığı) | Bu ifade doğru mu? | 0 ile 1 arasında tek bir olasılık | Bu mesaj bir iade talebi mi? |
Seçenekleri ve ölçeğin basamaklarını düz cümlelerle tarif edersiniz. Jev’i önceden kendi verinizle eğitmeniz gerekmez; anlattığınız seçeneklere bakarak ilk seferde karar verir. Makine öğrenmesinde buna zero-shot, yani örneksiz öğrenme denir.
Gerçek bir örnek
Şimdi gelin bunu gerçek bir örnekle görelim. Bağımsız test platformu AI/ML API, Jev’e şu müşteri mesajını gönderdi (AI/ML API):
“Bu ay API aboneliğim için iki kez ücret alındı ve destek 4 gündür cevap vermiyor. Bugün düzeltin, yoksa ekibimi başka bir sağlayıcıya taşıyorum.”
Aynı mesaj için tek çağrıda üç soru soruldu: Acil mi (Noul)? Hangi ekip ilgilenmeli (Choice)? Müşteri kaybı riski ne (Score: Düşük, Orta, Yüksek)? Jev’in cevabı, kısaltılmış haliyle:
{ "is_urgent": { "noul": 0.91 }, "team": { "choice": "billing", "confidence": 1 }, "churn_risk": { "score": 1.99, "confidence": 0.99 }}
Yani: yüzde 91 olasılıkla acil, kesinlikle fatura ekibinin işi ve kayıp riski en üst basamakta (0 = Düşük, 2 = Yüksek ölçeğinde 1,99). Jev bu isteği kendi sunucusunda 131 milisaniyede işledi; ağ gecikmesiyle birlikte toplam süre 0,95 saniye oldu.
Burada kritik bir nokta var: 0,91 bir karar değil, bir sinyaldir. Hangi eşiğin üstünde otomatik işlem yapılacağına, hangisinin altında bir insana sorulacağına sizin kodunuz karar verir.
Hızın Sırrı: Jev Okur, Ama Yazmaz
Şu soruyu sormak çok doğal: Jev de metni anlamıyor mu? Anlamadan doğru seçeneği bulması imkânsız olurdu. Evet, Jev de metni derinlemesine okur ve analiz eder. Fark okumada değil, cevabı dışarı verme biçiminde.
Kompozisyon mu, optik form mu?
Bir sınıfta dersi mükemmel bilen iki öğrenci düşünün. Soru: “Türkiye’nin başkenti neresidir?” İkisi de cevabı aynı anda bilir.
- LLM, kompozisyon yazan öğrencidir. “Türkiye Cumhuriyeti’nin başkenti Ankara’dır” cümlesini kâğıda kelime kelime döker. Ona “sadece Ankara yaz” deseniz bile, kelimeyi yine parça parça üretmek zorundadır.
- Jev, optik form dolduran öğrencidir. Önünde şıklar vardır: A) Ankara, B) İstanbul, C) İzmir. Yazı yazmaz; doğru şıkkı karalar ve kâğıdı teslim eder.
Makinenin içinde ne oluyor?
Bir LLM’den {"niyet":"iade"} gibi küçücük bir JSON cevabı istediğimizi düşünelim. Müşterinin mesajı yine aynı: “Ürün çok hızlı geldi ama rengini pek beğenmedim, iade edeceğim.”
Model bu cevabı tek seferde yazamaz. Önce ilk parçayı üretir, sonra o parçayı da okuyarak ikincisini, sonra üçüncüsünü… Tablo yaklaşık böyle bir bölünmeyi gösteriyor (gerçek bölünme modelin tokenizer’ına göre değişir):
| Adım | Model neyi görüyor? | Yazdığı parça |
|---|---|---|
| 1 | Mesaj + soru | {" |
| 2 | Mesaj + soru + {" | niyet |
| 3 | Mesaj + soru + {"niyet | ":" |
| 4 | Mesaj + soru + {"niyet":" | iade |
| 5 | Mesaj + soru + {"niyet":"iade | " |
| 6 | Mesaj + soru + {"niyet":"iade" | } |
Altı parça, ağın tamamından altı kez geçmesi demek. Üstelik kararın kendisi olan iade yalnızca 4. adımda çıkıyor; geri kalan beş adım parantez, tırnak ve alan adı yazmakla geçiyor. Üç alanlı bir JSON isteseydik (niyet, memnuniyet, iade_mi) bu sayı kabaca 15–20’ye çıkardı. Her adım bir öncekini beklemek zorunda olduğu için bunları paralel yapmak da mümkün değil.
Farkı ölçen küçük bir deney de var. Jev’in arayüzünü açık bir modelle (Qwen3.5-4B) taklit eden topluluk projesi openjev’de, tek bir RTX 3090 üzerinde 21 soruyu seçeneklerin puanını doğrudan okuyarak cevaplamak 1,02 saniye, aynı soruları JSON dizi yazdırarak cevaplamak 5,33 saniye sürmüş (Firecrawl). Bu Jev’in kendisi değil, ama aynı fikrin hız farkını küçük ölçekte gösteriyor.
Jev’de bu döngü yoktur. TypeSafe’in anlattığına göre Jev, durumu ve soruları tek bir geçişte okur ve paralel bir örnekleyiciyle bütün cevapları aynı anda hesaplar. Bir çağrıdaki sorular, durumun aynı tek okuması üzerinden birbirinden bağımsız değerlendirilir. Bu yüzden onuncu soruyu eklemek size token maliyeti getirir ama neredeyse hiç ek süre getirmez (Sanity).
Kısacası bir LLM cevabını parça parça yazar; Jev ise tanımladığınız bütün seçenekleri tek seferde puanlar ve kazananı bir sayı olarak yazılımınıza iletir.
LLM: Metni oku → Token yaz → Token yaz → Token yaz → ... → JSON metni → Kod ayrıştırır (her token için ağın tamamından bir geçiş)Jev: Durum + soruları oku → Bütün seçenekleri puanla → Tipli cevap (tek geçiş, döngü yok)
Peki Jev doğru seçeneği nasıl buluyor?
Kelime yazmıyorsa Jev “billing” ya da “technical” cevabına nasıl ulaşıyor? Kısa cevap: yazmıyor, okuyor ve puanlıyor. Destek mesajı örneğindeki üç seçenek üzerinden adım adım gidelim.
- Seçenekler girdinin içinde. Sorunun yanında her seçeneğin adı ve açıklaması da modele verilir: billing (ödeme ya da abonelik sorunları), technical (hata ve entegrasyon problemleri), sales (fiyat ya da hesap soruları). Seçenekler modelin dışında bir liste değil, okuduğu metnin parçası.
- Tek geçişte puanlama. Model mesajı, soruyu ve bütün seçenek açıklamalarını bir arada okur ve mesajın her seçeneğe ne kadar uyduğunu ölçer. Bunu cümleyle anlatmaz; her seçenek için bir sayı üretir. Üç seçenek varsa üç, 255 seçenek varsa 255 sayı, hepsi aynı geçişte.
- Sayılar olasılığa dönüşür. Puanlar, toplamı 1,0 olacak şekilde olasılıklara çevrilir (Towards AI). TypeSafe’in hızlı başlangıç örneğinde, Stripe bağlantısı üç gündür çalışmayan bir müşteri için sonuç şöyle: billing 0,159, technical 0,84, sales 0,001 (Firecrawl).
- En yüksek olan kazanır.
choicealanına en yüksek olasılıklı seçeneğin adı yazılır.
Bunu bir yarışma jürisine benzetebilirsiniz: Jüri üç adaya aynı anda puan kartı kaldırır, en yüksek puanı alan kazanır. Jev “technical” diye bir kelime yazmadı; “technical” seçeneği en yüksek puanı aldı.
Score aynı mantıkla çalışır, tek fark seçeneklerin sıralı olması. Her basamak için olasılık hesaplanır ve sonuç bu olasılıklarla ağırlıklandırılmış bir konumdur (AY Automate). Temsili bir hesap: “Sakin” %2, “Sinirli ama kibar” %91, “Çok öfkeli” %7 ise skor 0×0,02 + 1×0,91 + 2×0,07 = 1,05 çıkar. Skorun iki basamak arasına düşebilmesinin sebebi bu. Noul ise tek seçenekli bir durum: yalnızca “doğru” olasılığı döner.
Güven değeri neden olasılıktan farklı? Her Choice ve Score cevabıyla birlikte ayrı bir güven değeri de gelir. Bu, olasılığın tekrarı değil; dağılımın ne kadar keskin olduğunu anlatır (Towards AI). Aynı örnekte technical seçeneği 0,84 olasılık alırken güven değeri 0,596: çünkü ikinci seçeneğe de 0,159 pay düşmüş, dağılım tam keskin değil. Pratik kural: olasılık ne olduğunu söyler, güven otomatik işlem yapıp yapmamanız gerektiğini.
Dürüst olmak gerekirse TypeSafe, Jev’in mimarisini ve örnekleyicisini ayrıntılı yayımlamadı. Ama aynı fikri uygulayan bağımsız açık kaynak projeler var. Örneğin AnyJev, mevcut dil modellerinin seçenek etiketleri üzerindeki ham puanlarını okuyup olasılığa çeviriyor ve klonların da çoğunlukla bunu yaptığını anlatıyor (PyPI). Yani prensip bilinen bir şey. Jev’in iddiası, bu puanların kalibre çıkması için modelin özel bir yöntemle eğitilmiş olması.
Olasılıklar neden güvenilir olsun?
Jev’in eğitimindeki fark da buradan geliyor. Sohbet botları, insanların beğendiği cevapları ödüllendiren RLHF yöntemiyle eğitilir. Jev ise TypeSafe’in RLCD (Kalibre Kararlar için Pekiştirmeli Öğrenme) dediği bir yöntemle eğitildi. Amaç, modelin “yüzde 90 eminim” dediği cevapların gerçekten yaklaşık yüzde 90 oranında doğru çıkması.
TypeSafe, Jev’in mimarisini yalnızca ana hatlarıyla anlattı; parametre sayısı, eğitim verisi ve teknik bir makale henüz yayımlanmadı (AI/ML API).
“Ama LLM’e de ‘sadece JSON döndür’ diyebilirim”
Haklısınız. Bugünkü LLM’lerin Structured Outputs (yapılandırılmış çıktı) ve function calling özellikleri, modeli belirlediğiniz şemaya yüzde yüz uymaya zorlayabiliyor. Jev çıktığında Hacker News’te en çok dile getirilen itiraz da buydu: Geçerli bir etiket döndürmek tek başına yeni bir şey değil (AI/ML API).
O halde Jev’in getirdiği yenilik ne? Üç şey: daha düşük fiyat, daha düşük gecikme ve her cevapla gelen kalibre bir olasılık. Bunların ne kadar değerli olduğu, Jev’i hangi LLM ile kıyasladığınıza bağlı.
AI/ML API, Eylül 2026’da Jev’i Claude Opus 5.5, GPT-6 Sol ve üç ucuz LLM’e karşı 900 örnek üzerinde test etti. Tablo bu bağımsız testin sonuçlarını özetliyor (AI/ML API):
| Kriter | LLM (Structured Outputs ile) | Jev |
|---|---|---|
| Çıktı nasıl üretilir? | Şemaya zorlanmış metin, token token yazılır | Yalnızca tipli değerler, tek geçişte hesaplanır |
| Sunucudaki gecikme (medyan) | 0,89 – 2,55 sn | 0,14 sn |
| Uçtan uca gecikme (medyan) | 1,41 – 3,21 sn | 0,83 sn |
| Fiyatlandırma | Girdi ve çıktı ayrı ödenir; ör. GPT-6 Sol: milyon token başına 2,60 $ girdi, 13 $ çıktı | Yalnızca girdi: milyon token başına 0,042 $; çıktı ücretsiz |
| Ne kadar emin? | Bilinmez; kendine puan yazdırırsanız o da ölçülmemiş bir metindir | Her cevapla birlikte bir olasılık ve güven değeri |
| Doğruluk | 77 seçenekli yönlendirmede en iyi LLM’ler yaklaşık 7 puan önde | İçerik denetiminde en iyi F1 skoru, kalite puanlamada en zayıf |
Tablodan çıkan en önemli ders şu: Jev’in sunucudaki hızı 6 ila 18 kat fazla. Ama her çağrı internet üzerinden yaklaşık 0,7–0,9 saniyelik ağ yolculuğu yapınca bu fark uçtan uca 1,7–3,9 kata iniyor.
Fiyat için de benzer bir tablo var. Jev, sınıflandırma görevlerinde Claude Opus 5.5’ten yaklaşık 85 kat, GPT-6 Sol’dan 17–30 kat ucuz çıktı. Ancak GPT-6 Luna ve DeepSeek V4 Flash gibi ucuz modellerle maliyet kabaca başa baş. Yani “her LLM’den 100 kat ucuz” iddiası her durumda geçerli değil.
Jev’in asıl fark yarattığı yer üçüncü madde: güven sinyali. Bir LLM “fatura” dediğinde, bunun yazı tura mı yoksa kesin mi olduğunu bilemezsiniz. Jev’in testte 0,9 ve üzeri güvenle verdiği sınıflandırma cevapları yüzde 94–96 oranında doğru çıktı. Bu oran, aynı veride Claude Opus 5.5 dahil hiçbir modelin genel doğruluğuna ulaşamadığı bir seviye.
Somut Senaryo: Bir Milyon Müşteri Yorumu
Bir e-ticaret siteniz olduğunu ve gelen yorumları otomatik sınıflandırmak istediğinizi düşünelim. Örnek yorum:
“Ürün çok hızlı geldi ama rengini pek beğenmedim, iade edeceğim.”
LLM yaklaşımında modele “bana sadece şu JSON’u döndür” dersiniz. Model şunu yazar:
{ "karar": "İade", "eminlik_yuzdesi": 0.85 }
Cevap doğru görünüyor. Ama “eminlik_yuzdesi” de modelin yazdığı bir metin; ölçülmüş bir olasılık değil. Üstelik her parantez ve tırnak için çıktı tokenı ödediniz.
Jev yaklaşımında aynı yorumu üç soruyla gönderirsiniz: niyet nedir (Choice: iade, memnun, şikâyet), memnuniyet kaç (Score: 1–5), bu bir iade talebi mi (Noul). Dönen cevap şuna benzer (temsili örnek):
{ "niyet": { "choice": "iade", "confidence": 0.93 }, "memnuniyet": { "score": 2.1, "confidence": 0.81 }, "iade_mi": { "noul": 0.95 }}
Jev bu JSON’u “düşünerek” yazmadı. Seçenekleri puanladı, sayıları hesapladı; yazılım katmanı bu ham değerleri alıp anında işledi.
Fatura ne kadar tutar?
Bağımsız testteki içerik denetimi görevi bu senaryoya en yakın örnek: kısa bir metin, tek bir evet/hayır sorusu. Bir milyon karar için ödenen tutarlar şöyle (AI/ML API):
| Model | 1 milyon karar için maliyet |
|---|---|
| GPT-6 Luna | 16 $ |
| Jev 1.13 | 19 $ |
| DeepSeek V4 Flash | 42 $ |
| Gemini 3.5 Flash | 66 $ |
| GPT-6 Sol | 318 $ |
| Claude Opus 5.5 | 1.621 $ |
Günde yüz bin yorum işleyen bir site için bu, Opus ile ayda yaklaşık 4.900 dolar, Jev ile yaklaşık 57 dolar demek. Ama tablonun en tepesine dikkat: En ucuz LLM’ler Jev’le aynı fiyat bandında. Jev’in onlara karşı üstünlüğü fiyat değil; hız ve güven değeri.
Bir uyarı daha: Jev yalnızca girdiyi faturalar, ama sorular ve her seçeneğin açıklaması da girdiye dahildir. 77 seçenekli bir yönlendirme görevinde Jev’in maliyeti (98 $) DeepSeek V4 Flash’ı (77 $) geçti. Seçenek açıklamalarını kısa tutmak faturayı doğrudan düşürür.
En İyi İkili: Jev Önde, LLM Arkada
Jev’i bir LLM’in rakibi olarak görmek yerine, onu LLM’in kapısındaki görevli gibi düşünmek daha doğru. En popüler kullanım şu: Gelen her isteğe önce Jev bakar. Emin olduğu işi kendisi bitirir, emin olmadığını pahalı ve yavaş LLM’e ya da bir insana devreder.
Gelen istek ↓Jev karar verir (seçim + güven) ↓Güven ≥ 0,9 ? ── evet ──→ Kod uygular (hızlı ve ucuz) │ hayır ↓LLM ya da insan (belirsiz kalan pay)
Eşik sizin elinizde: Yükselttikçe Jev daha az işi tek başına yapar ama yaptığı işte daha az hata eder.
Bu düzende Jev üç farklı rol üstlenebilir:
- Yönlendirici (Router): İstek hangi araca, hangi ajana, hangi ekibe gitmeli?
- Kapı (Gate): Bu istek güvenli mi, kurallara uygun mu, işleme alınsın mı?
- Hakem (Judge): Bir yapay zekâ ajanının ürettiği sonuç kabul edilebilir mi?
TypeSafe’in hedeflediği alanlar da bunlar: servis taleplerini sınıflandırmak, faturaları değerlendirmek, güvenlik alarmlarını önceliklendirmek ve yapay zekâ ajanlarının çıktılarını kontrol etmek (SiliconANGLE). Metin yazılması gereken yerde iş yine LLM’e kalıyor.
Rakamlar ne diyor?
Bağımsız testte bu “önce Jev” düzeni denendi. Jev’in 0,9 ve üzeri güvenle cevap verdiği istekler doğrudan kabul edildi, geri kalanı Claude Opus 5.5’e gönderildi (AI/ML API):
| Görev | Düzen | Doğruluk | 1 milyon karar maliyeti |
|---|---|---|---|
| Niyet yönlendirme (77 seçenek) | Yalnızca Claude Opus 5.5 | %85,7 | 8.243 $ |
| Niyet yönlendirme (77 seçenek) | Önce Jev, kalanı Opus 5.5 | %85,3 | 3.154 $ |
| İçerik denetimi | Yalnızca Claude Opus 5.5 | %84,0 | 1.621 $ |
| İçerik denetimi | Önce Jev (0,8 eşik), kalanı Opus 5.5 | %85,7 | 724 $ |
Sonuç çarpıcı: Aynı doğruluk, maliyetin yarısından az. İçerik denetiminde karma düzen, Opus’u tek başına kullanmaktan biraz daha doğru bile çıktı. Üstelik isteklerin yaklaşık üçte ikisi Opus’un 3 saniyelik bekleme süresi yerine Jev’in hızıyla cevaplandı.
Hızın neleri mümkün kıldığını göstermek için TypeSafe, Jev’e Doom oyununu gerçek zamanlı oynattı. Bot saniyede on karar sorgusu yaptı ve saatlik maliyeti yaklaşık 7 dolar oldu (VKTR).
Eşiği nasıl seçersiniz? Kendi verinizden 200–300 örneği elle etiketleyin, Jev’i bunlarda çalıştırın ve her güven eşiğinin üstündeki doğruluğa bakın. Doğruluğun kabul edilebilir olduğu en düşük eşiği seçin; altında kalan pay, LLM’e ödeyeceğiniz kısımdır.
AI Agent’larda Jev: Skill ve Araç Seçimi Gerçekten İşe Yarıyor mu?
Bir AI agent’ın önünde yüzlerce skill (ya da araç) olduğunu düşünelim: powerpoint, excel, pdf, word… Kullanıcı “geçen haftaki sunumumun slaytlarını düzenle” diyor. Agent’ın ilk işi hangi skill’i yükleyeceğine karar vermek. Bu, Jev’in şekline tam uyan bir karar: seçenekler belli, cevap tek bir etiket ve her turda tekrar ediyor.
Bu bir varsayım değil. Üç gerçek örnek var; her birinde ölçümü kimin yaptığını da belirtiyorum.
1. Skill seçimi: Hermes agent’ı ve TypeSafe cookbook’u
Sorun şu: Hermes, skill listesindeki açıklamaları yaklaşık 60 karaktere kısaltıyor. Katalog 190’ın üstüne çıkınca agent neredeyse hiç bilgi olmadan tahmin yürütüyor; örneğin .pptx düzenleyen skill, oluşturan skill gibi okunuyor. Çözüm, her istekte iki küçük Jev çağrısı (Hermes Marketplace):
- Bütün skill adları tek bir Choice sorusunun seçenekleri, skill açıklamaları da seçenek tanımları oluyor. Aynı çağrıda üç Noul daha soruluyor; örneğin “Bu istek bir işlem gerektiriyor mu?”. Bu kapıların ortalaması 0,30’un altındaysa hiçbir skill önerilmiyor.
- En iyi üç aday, tam açıklamalarıyla yeniden puanlanıyor.
Temsili bir çağrı şöyle görünür:
{ "state": "Geçen haftaki sunumumun slaytlarını düzenle", "questions": { "skill": { "type": "choice", "instructions": "Hangi skill bu isteği karşılar?", "criteria": { "powerpoint": "Sunum dosyalarını (.pptx) oluşturur ve düzenler", "excel": "Tablo ve hesaplama dosyalarını (.xlsx) hazırlar", "pdf": "PDF dosyalarını okur, birleştirir ve böler" } }, "isleme_gerek_var_mi": { "type": "noul", "instructions": "Bu istek bir dosya üzerinde işlem gerektiriyor mu?" } }}
Projenin kendi örneğinde Almanca “Bearbeite die Folien meiner Präsentation von letzter Woche” (geçen haftaki sunumumun slaytlarını düzenle) cümlesi, skill adıyla hiçbir ortak kelimesi olmamasına rağmen powerpoint skill’ine eşleşiyor (uygunluk 0,90). “Bir bulut fonksiyonu ile sunucu arasındaki fark nedir?” gibi düz bir bilgi sorusunda ise hiçbir skill önerilmiyor.
Ölçüm TypeSafe’in kendi cookbook’una ait: 488 istekte yanlış skill yükleme oranı %16,8’den %7,3’e, gereksiz skill yükleme oranı %9,8’den %4,0’e düşmüş. Bir seçim 0,3–0,9 saniye sürüyor.
2. Context tasarrufu: langchain-skill-router
Token Kaçağı yazısında tool tanımlarının agent daha çalışmaya başlamadan on binlerce token yiyebildiğini anlatmıştık. Skill katalogları da aynı problemi yaşıyor: her model çağrısında bütün skill adları ve açıklamaları prompt’a giriyor.
langchain-skill-router adlı açık kaynak proje bunu Jev’e yaptırıyor: her kullanıcı turunda hangi skill’lerin gerektiğine Jev karar veriyor ve yalnızca onlar yükleniyor. Projenin 236 skill’lik bir katalogda, 55 konuşma × 5 tur (275 tur) üzerinde yaptığı ölçüm (PyPI):
| Ölçüt | Katalogun tamamı prompt’ta | Jev ile seçilen skill’ler |
|---|---|---|
| Tur başına girdi tokenı | 113,0 bin | 25,8 bin (4,4 kat az) |
| Doğru skill modelin önünde mi? | %55 | %85 |
| Doğru cevap oranı | %88 | %90 |
Doğruluktaki 1,5 puanlık fark istatistiksel olarak anlamlı değil; yani sonuç “aynı doğruluk, çok daha az context.” Üç dikkat noktası var. Proje TypeSafe’ten bağımsız bir topluluk çalışması. Veri üretilmiş, tek hakem ve tek ajan modeliyle ölçülmüş. Ayrıca yanlış skill yüklemek en pahalı hata: yanlış skill’le çalışılan 18 turda cevapların %72’si doğruyken, doğru skill’le %92’si doğru çıkmış. Hakem zaman aşımına uğrar ya da kesintiye girerse agent katalogun tamamını görüyor; yani sistem arızalanmak yerine eski davranışa dönüyor.
3. Araç çağrısı koruması: pi-warden
Bir agent npm run db:reset komutunu çalıştırmak üzere. Kullanıcı “veritabanını sıfırla” dediyse bu doğru; “şuraya bir kolon ekle” dediyse felaket. Komut aynı olduğu için bir regex listesi bu ikisini ayıramaz.
pi-warden, her bash, write ve edit çağrısından önce görevi, agent’ın planını ve bekleyen komutu Jev’e dört tipli soruyla gönderiyor: İşlem geri alınamaz mı? Görev dışı mı? Bir şeyi değiştiriyor mu? Kapsamı ne? Jev yaklaşık 250 ms’de cevaplıyor, tutup tutmamaya ise kod karar veriyor. Proje sahibinin paylaştığı kayıtlara göre yaklaşık 17.000 çağrıda 42 kez durdurmuş ve durdurmaların yaklaşık %88’i haklı çıkmış (Firecrawl). Bu rakam topluluk projesinin kendi bildirimi; bağımsız bir doğrulama değil.
Üç örnekteki ortak desen
Kullanıcı isteği ↓Jev: Hangi skill ya da araç? (Choice) + Gerek var mı? (Noul) ↓Güven yüksek → seç ve yükleGüven düşük → kısa liste sun ya da LLM'e bırakGerek yok → hiçbir şey yükleme
Bu desenin işe yaraması için dört şeye dikkat etmek gerekiyor:
- Seçenek sınırı. Bir Choice en fazla 255 seçenek alıyor ve durum 32 bin token ile sınırlı. Katalog büyükse parçalara bölünüp parça kazananları yeniden sıralanıyor.
- Seçenek sırası. TypeSafe’in belgelerine göre Jev bazen listedeki ilk seçeneğe yöneliyor (Steve Kinney). Seçenekleri farklı sıralarla deneyin.
- Kısa durum. Tüm konuşma geçmişini göndermek kötü bir varsayılan; alakasız ayrıntılar doğruluğu düşürüyor (Firecrawl).
- “Gerek yok” cevabı. Her istek bir skill gerektirmez. Hiçbir şey yüklememek de geçerli ve çoğu zaman doğru bir karar.
Hepsi erken dönem örnekler. Kendi katalogunuzda 200–300 etiketli örnekle ölçmeden eşiği sabitlemeyin.
Agent’ın hangi bilgiyi context’inde taşıması gerektiğini Agentic AI’da Context Problemi yazısında, agent’ın yazdığı koda nasıl güvenebileceğimizi ise Çalışan Kod Yetmez yazısında ele almıştık.
Dürüst Olalım: Jev’in Yapamadıkları
Bir teknolojiyi anlatırken yalnızca övgü yazmak kolay. Jev’in net sınırları var ve TypeSafe bunların bir kısmını kendi belgelerinde de listeliyor.
“Halüsinasyon görmez” ne demek, ne demek değil?
TypeSafe, Jev’in halüsinasyon göremeyeceğini söylüyor. Bu iddia format hakkındadır, doğruluk hakkında değil. Jev listenizde olmayan bir seçenek uyduramaz, bozuk bir JSON döndüremez. Ama 255 seçeneğinizden yanlış olanı, yüksek bir güvenle seçebilir (Sanity).
Bağımsız test bunu rakamla gösteriyor: 900 çağrıda Jev bir kez bile şema dışına çıkmadı. Ama 77 seçenekli yönlendirmede 0,9 ve üzeri güvenle verdiği 197 cevabın 12’si yanlıştı (AI/ML API). Yüksek güven, Jev’in emin olduğunu gösterir; aklınızdaki etiketi seçtiğini garanti etmez.
Zayıf olduğu işler
- Saymak ve hesaplamak: Sayılacak öğe arttıkça hatası da artıyor.
- Tarihler: Tarihleri sıralı değerler olarak değil metin olarak görüyor; iki tarihten hangisinin önce geldiğini güvenilir biçimde söyleyemiyor.
- Kalite değerlendirmek: Bir cevabın ne kadar iyi olduğunu puanlamada altı model arasında en zayıfı oldu; insan puanlarıyla uyumu 0,39’da kaldı, en iyi LLM’ler 0,48–0,49’a ulaştı.
- Açık uçlu sorular: Cevap alanının önceden bilinmesi ve sınırlı olması gerekiyor.
- Metin dışı girdi: Görsel, ses veya PDF okuyamıyor; yalnızca metin ve JSON.
TypeSafe bu zayıflıkların bir kısmını kendi belgelerinde de açıkça kabul ediyor. Pratik çözüm basit: Matematiği ve tarih karşılaştırmasını önce kendi kodunuzda yapın, sonra sonucu Jev’e sorun. Seçenek sırasına da dikkat edin: Jev bazen listedeki ilk seçeneğe yöneliyor (Steve Kinney), bu yüzden seçenekleri farklı sıralarla deneyin. Durum fazla kalabalıksa doğruluk düşüyor; yalnızca kararın ihtiyaç duyduğu bilgiyi gönderin (Firecrawl).
Rakamların çoğu üreticiden geliyor
Etkileyici hız ve maliyet rakamlarının önemli bir kısmı TypeSafe’in kendi ölçümleri. Şirketin dört iş akışlı kendi testinde Jev yüzde 67,8 puan aldı: GPT-5.6 Terra ile aynı seviyede, GPT-5.6 Sol (%74,1) ve Claude Opus 5 (%73,1) gerisinde. Üstelik bu testte “doğruluk”, gerçek cevaplarla değil, başka modellerin ortak cevabıyla uyum anlamına geliyor (Sanity).
Son olarak Jev kapalı bir model. Ağırlıkları yayımlanmadı; yalnızca TypeSafe’in sunucularında, internet üzerinden kullanılabiliyor. Verisini kendi sunucusundan çıkaramayan kurumlar için bu tek başına engel olabilir.
Jev Hakkında Sık Sorulan Sorular
Jev nedir?
Jev, TypeSafe AI’ın 15 Eylül 2026’da erken erişime açtığı bir karar modelidir. Metin ya da JSON bir durumu okur, tanımladığınız sorulara seçim, puan ya da olasılık olarak cevap verir; cümle, kod ya da açıklama üretmez.
Jev bir LLM mi?
Hayır. Bir LLM cevabı token token yazar; Jev bütün seçenekleri tek geçişte puanlar. Bu yüzden sohbet edemez ve kod yazamaz, ama sınıflandırma ve yönlendirme gibi işlerde çok daha hızlı ve ucuzdur.
Jev halüsinasyon görür mü?
Şemanın dışında bir değer üretemez; ama şemanın içinde yanlış bir seçeneği yüksek güvenle seçebilir. Bağımsız testte 77 seçenekli yönlendirmede 0,9 ve üzeri güvenle verilen 197 cevabın 12’si yanlıştı.
Jev ne kadar hızlı ve ucuz?
TypeSafe, 70–500 ms uçtan uca gecikme ve milyon girdi tokenı başına 0,042 dolar fiyat bildiriyor; çıktı ücretsiz. Bağımsız testte sunucu tarafı medyan 0,14 saniye, uçtan uca 0,83 saniye ölçüldü.
Jev’e nasıl erişilir?
Ağırlıkları kapalı; yalnızca TypeSafe’in API’si ile OpenRouter, Vercel AI Gateway ve AI/ML API gibi aracılar üzerinden kullanılabiliyor. Erişim koşulları lansmandan beri birkaç kez değiştiği için güncel durumu TypeSafe konsolundan kontrol edin.
Jev AI agent’larda skill ya da araç seçimi için kullanılabilir mi?
Evet. Hermes agent’ı için yazılmış skill seçici, TypeSafe’in cookbook ölçümünde yanlış skill yüklemeyi %16,8’den %7,3’e düşürdü. langchain-skill-router ise 236 skill’lik bir katalogda tur başına girdi tokenını 113 binden 25,8 bine indirdi ve doğruluğu korudu.
Sonuç
Bu yazıda Jev’i inceledik. Jev’in metin yazmayan, yalnızca seçim, puan ya da olasılık döndüren bir System One modeli olduğunu; bir LLM cevabı token token yazarken Jev’in bütün seçenekleri tek geçişte puanladığını ve bu sayede çok daha hızlı ve ucuz çalıştığını gördük. AI agent’larda skill ve araç seçimi için gerçek örnekler olduğunu, ama Jev’in yanlış seçeneği yüksek güvenle de seçebileceğini ve saymak, tarih karşılaştırmak, kalite tartmak gibi işlerde zayıf kaldığını da konuştuk.
Bir LLM, her soruya devasa bir kütüphaneyi tarayarak cevap veren titiz bir profesör gibidir. Ona “tek kelimeyle söyle” deseniz bile o kelimeyi özenle, parça parça yazar. Jev ise önüne gelen topu düşünmeden doğru köşeye çeviren bir kalecidir. Cümle kurmayı bilmez; ama refleksi saniyenin onda birini bulmaz.
Farkı bir de şöyle düşünün: Bir arkadaşınıza “sinemaya kaçta geleceğini bana SMS’le yaz” dediniz. LLM kullanmak, arkadaşınızın “Merhaba, planlarıma göre saat yirmide orada olacağım” diye yazması ve sizin saati mesajın içinden ayıklamanız gibidir. Jev kullanmak ise arkadaşınızın ekrandaki “Geleceğim” düğmesine basması gibi: Dil yok, yalnızca net bir sinyal var.
İsmin arkasındaki fikir
Jev adı, 19. yüzyıl iktisatçısı William Stanley Jevons’tan geliyor. Jevons paradoksuna göre bir şeyi daha verimli hale getirmek, ona olan toplam talebi azaltmaz; tam tersine artırır. TypeSafe’in mesajı açık: Kararlar ucuzlayınca daha az değil, çok daha fazla karar verilecek (Sanity).
Piyasa bu fikre şimdiden ciddi bir oy verdi. TypeSafe, lansmandan yaklaşık üç hafta sonra, 9 Ekim 2026’da Andreessen Horowitz liderliğinde yaklaşık 870 milyon dolar yatırım aldı ve 7,5 milyar dolar değerlemeye ulaştı (Bloomberg). Aynı günlerde OpenAI, GPT-6 Luna tabanlı kendi karar API’sini beta olarak açtı (Let’s Data Science). Açık kaynak tarafında da on gün içinde en az altı “Jev benzeri” model çıktı (AI/ML API).
Yani mesele artık “Jev mi, LLM mi?” sorusu değil. Asıl soru şu: Yazılımınızdaki hangi karar bir profesörü, hangisi bir kaleciyi hak ediyor? Metin yazmak, akıl yürütmek ve kaliteyi tartmak profesörün işi olarak kalacak. Ama günde milyonlarca kez verilen “bu nereye gidecek?” kararları, giderek daha çok kalecilere devredilecek gibi görünüyor.
Bir sonraki yazılarda görüşmek üzere.
İyi çalışmalar.

